Starter
1 compacte AI-server
bijv. Mac mini · tot ±15 gebruikers
- Lokale chat-assistent
- RAG over één kennisbron
- 2 lokale modellen
- Training voor je team
- Volledig offline na oplevering
Een AI-assistent die antwoord geeft uit jullie eigen dossiers, handleidingen en offertes, mét bronvermelding. Hij draait op eigen hardware in je netwerk: een Mac mini, een Mac Studio of een GPU-server, afgestemd op het aantal gebruikers en de modellen. We trainen je team en zetten daarna de verbinding met de cloud dicht: klantgegevens gaan het pand niet meer uit. Voor accountants, notarissen, advocaten, zorg, HR en technische bedrijven.
30 minuten · vrijblijvend · reactie binnen één werkdag
Na de installatie blokkeren we al het uitgaande AI-verkeer. Geen OpenAI, geen Google, en een veel kleiner risico op datalekken.
Eenmalig hardware en installatie, daarna geen gebruikskosten per vraag. Hoe meer je team het gebruikt, hoe goedkoper het wordt.
Van een stille Mac mini in de meterkast tot een GPU-server in je serverruimte. We kiezen wat past bij je gebruikers en modellen.
Data blijft fysiek bij jou. Met logging, rechten per gebruiker en documentatie voor je dossier.
Een vast traject van een paar weken. We werken op locatie, met jouw team.
Welke kennis zit waar? We brengen documenten, systemen en use cases in kaart en kiezen de juiste modellen en hardware.
We plaatsen en configureren de hardware in je eigen netwerk: Mac mini’s of een Mac Studio, of een Linux-server met NVIDIA-GPU’s voor zwaardere modellen en meer gebruikers. Lokale modellen via Ollama, MLX of vLLM.
We koppelen handleidingen, SharePoint, mappen en archieven. Antwoorden met bronvermelding, alleen op documenten waar de gebruiker recht op heeft.
Prompts, eigen terminologie en lokale agents voor jullie taken: offertes, samenvattingen, e-mailconcepten, zoeken in dossiers.
Hands-on trainingen voor gebruikers en een beheerderstraining voor IT. Inclusief AI-geletterdheid voor de AI Act.
We sluiten alle uitgaande verbindingen af. Updates gaan alleen nog via een gecontroleerd onderhoudsvenster. Daarna draait alles lokaal.
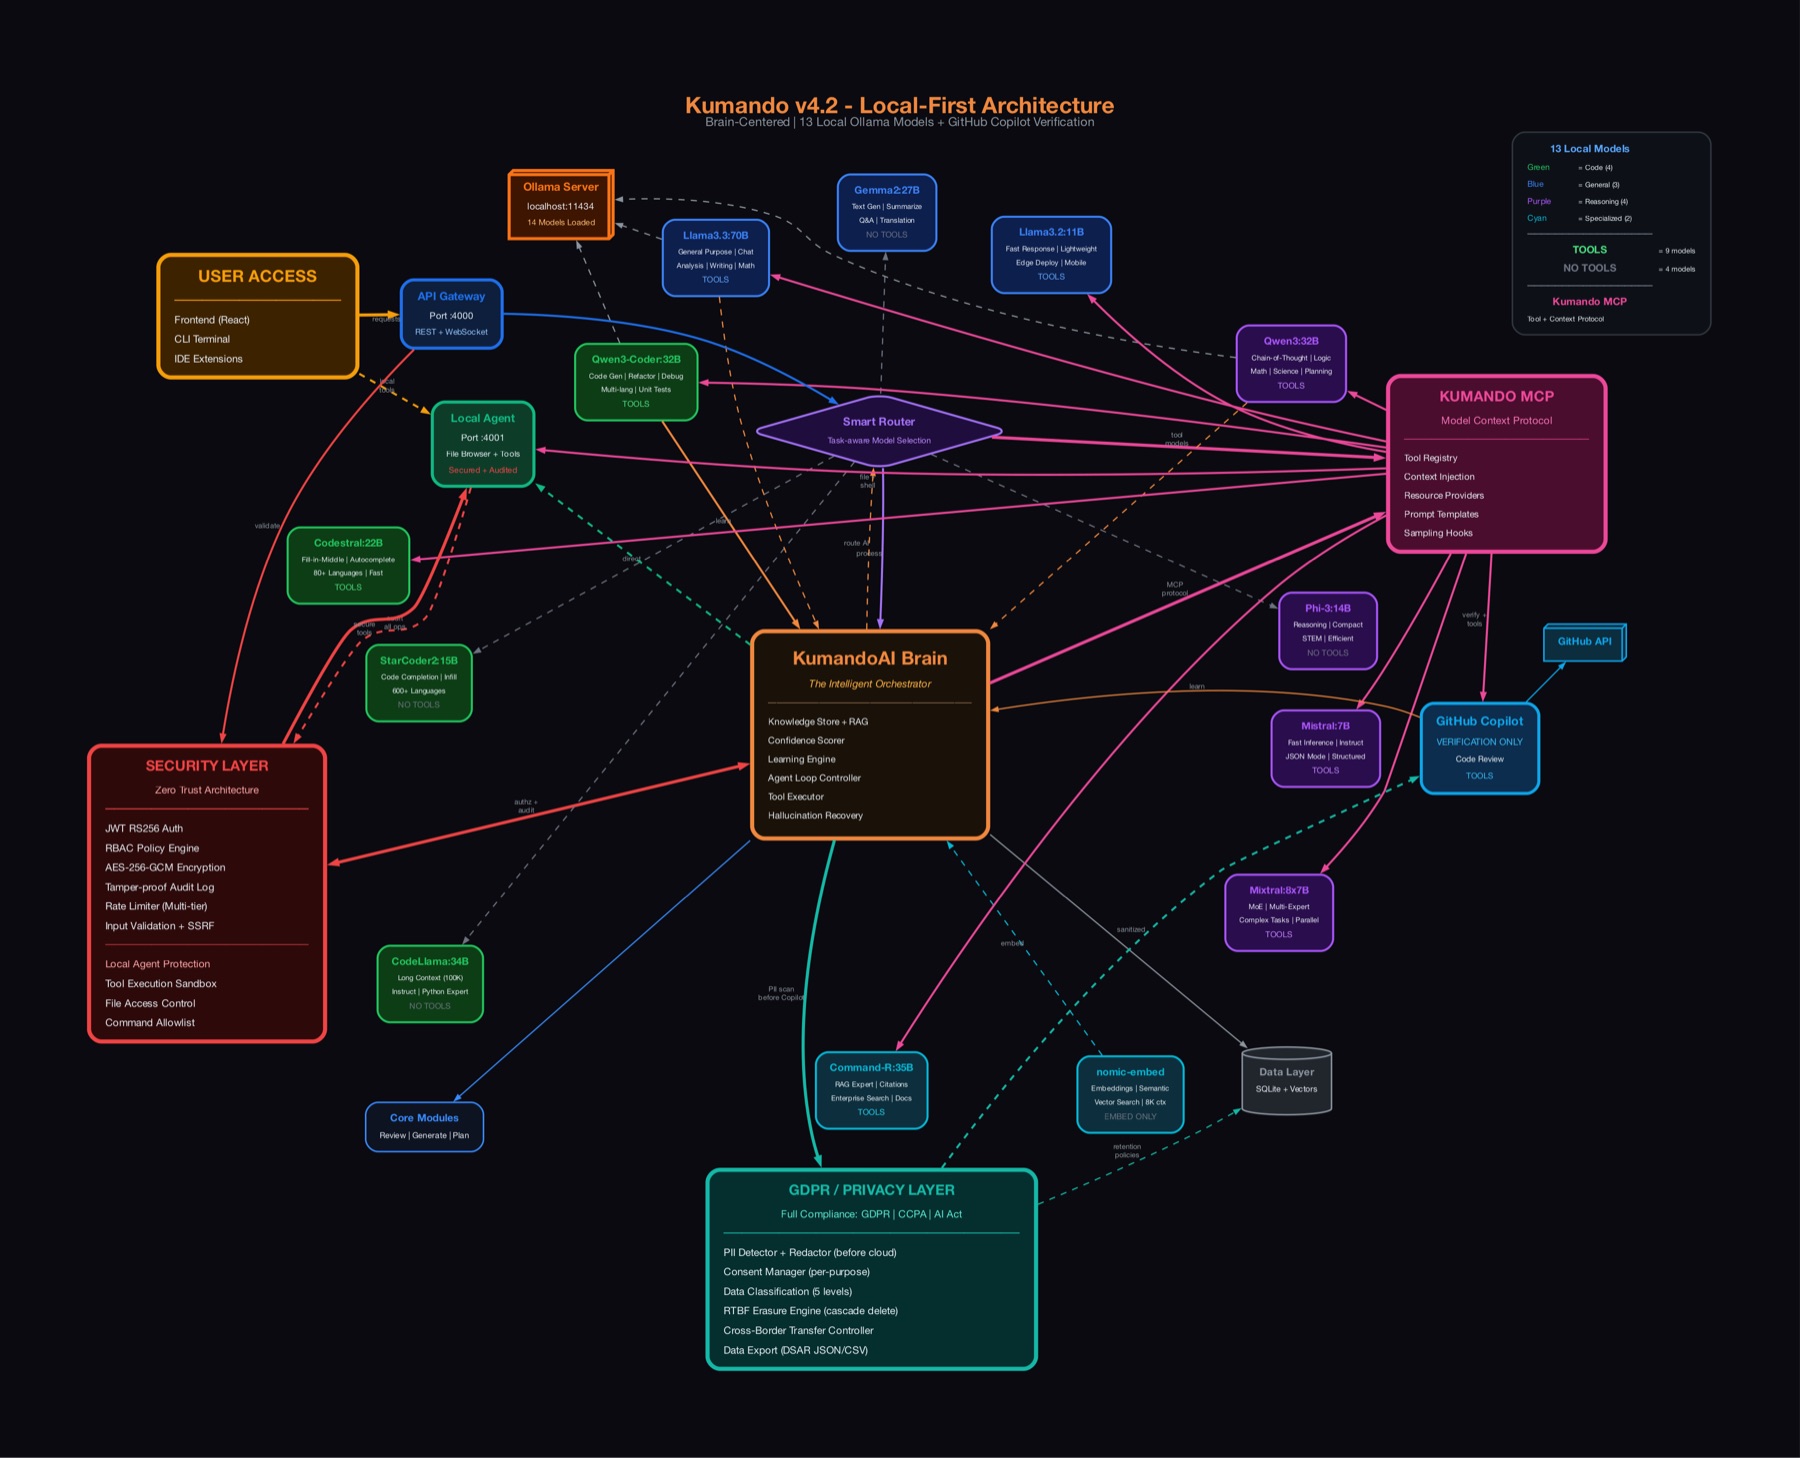
Dit is dezelfde local-first architectuur die we voor onze eigen AI-softwarefabriek Kumando hebben gebouwd: meerdere lokale modellen, een slimme router die per taak het juiste model kiest, RAG, tools en een privacylaag.
Hardware tegen kostprijs, installatie en configuratie op uurtarief, training per sessie. Optioneel onderhoud met gecontroleerde updates.
Voor de meeste bedrijfstaken wel: samenvatten, zoeken in documenten, e-mails en offertes opstellen, vragen beantwoorden over je eigen kennis. Met RAG over jouw data presteren ze vaak beter dan een algemeen cloudmodel dat je bedrijf niet kent.
Wat past bij je team en je modellen. Voor kleine teams is een Mac mini of Mac Studio vaak ideaal: Apple Silicon deelt geheugen tussen CPU en GPU, dus grote taalmodellen draaien stil en zuinig. Voor veel gebruikers, zware modellen of fine-tuning plaatsen we een Linux-server met NVIDIA-GPU’s. Je bestaande serverruimte kan ook.
Na oplevering blokkeren we op de firewall alle uitgaande verbindingen van de AI-systemen. Modellen, documenten en gesprekken blijven binnen je netwerk. Updates doen we alleen tijdens een vooraf afgesproken onderhoudsvenster.
Eén compacte server (bijvoorbeeld een Mac mini) is genoeg voor een klein team. Voor meer gebruikers of zwaardere modellen plaatsen we een Mac Studio of een GPU-server, met een router die de belasting verdeelt.
Ja. Je kunt modellen, kennisbronnen, agents en hardware toevoegen. Alles blijft van jou en draait op jouw apparaten.
Plan een gratis gesprek van 30 minuten. Je krijgt eerlijk advies over wat we zouden bouwen, wat het kost en wat het oplevert, ook als je daarna niet met ons verder gaat.